
PDF-документ может не попадать в поиск по нескольким несвязанным причинам, и каждая из них блокирует индексацию на своём уровне. Разберём проблему последовательно — от содержимого файла до сигналов для поисковика.
Слой текста: основа индексации PDF
Поисковый робот читает текст, а не картинку. PDF, созданный из сканов без распознавания, содержит только изображения страниц — слов в нём нет. Google умеет запускать OCR на таких файлах, но это ненадёжный резерв, а не основной путь. Яндекс в справке прямо указывает: у документа только из изображений обрабатываются первые три страницы, остальные остаются непрочитанными.
Проверить текстовый слой просто: откройте PDF, выделите мышью абзац и вставьте его в текстовый редактор. Если вместо связного текста — набор символов или пустая строка, документ нужно пересоздать с распознаванием. После OCR обязательно проверяйте результат вручную: таблицы, колонки, перевёрнутые страницы и сноски часто требуют отдельной правки порядка чтения.
Ограничения формата
Оба поисковика документируют ограничение по размеру: Яндекс индексирует PDF до 10 МБ, файл больше лимита не попадёт в поиск. Google читает первые 64 МБ PDF и отбрасывает всё, что дальше. Для обоих поисковиков безопаснее держаться в пределах 10 МБ. Файл, который превышает лимит, будет проигнорирован целиком или обрезан. Проверьте размер перед публикацией — сжать PDF без потери качества текста позволяет большинство инструментов экспорта.
Отдельная ловушка — декоративные элементы. Если заголовки раздела или ключевые данные вставлены как картинки ради точной вёрстки, поисковик их не прочитает даже при наличии общего текстового слоя.
Доступ робота к файлу
Правильный текст внутри файла бесполезен, если URL закрыт от скачивания. Проверьте три точки:
robots.txt. Если путь к PDF накрыт директивой Disallow, краулер не получит файл. Заодно это означает, что он не сможет прочитать HTTP-заголовок ответа — в том числе директиву noindex в X-Robots-Tag. Сначала убедитесь, что robots.txt разрешает путь.
Код ответа. Сервер должен отдавать HTTP 200 с типом содержимого application/pdf. Редирект 301/302 — не проблема, если конечный адрес тоже доступен и содержит правильный файл. Ответ 403 или 503 под ботом при 200 в браузере — антибот-защита: краулер до файла не добирается.
Авторизация. PDF за логином, токеном или IP-ограничением не индексируется. Файл должен быть публично доступен без промежуточных страниц.
X-Robots-Tag: директива в HTTP-ответе
Внутри PDF-файла нет места для мета-тега robots. Вместо него поисковики читают HTTP-заголовок X-Robots-Tag, который сервер или CDN добавляет к ответу на запрос файла. Директива noindex в этом заголовке полностью запрещает файлу участвовать в выдаче:
X-Robots-Tag: noindexТакой заголовок легко появляется после миграции или смены CDN-конфигурации и остаётся незамеченным, пока страница не пропадёт из индекса. Проверяйте заголовки ответа для URL файла отдельно — браузер их обычно не показывает.
Важный порядок: если robots.txt запрещает путь, краулер не загружает файл и не читает X-Robots-Tag. Сначала исправьте robots.txt, потом проверяйте заголовки.
Дубли URL и canonical
Один PDF, доступный по нескольким адресам — http и https, с www и без, с параметрами и без — создаёт проблему выбора канонического URL. Поисковик может выбрать не тот адрес, и тогда ваш вариант не попадёт в выдачу.
Для PDF предпочтительный адрес задаётся HTTP-заголовком в ответе дублирующей версии:
Link: <https://example.com/files/guide.pdf>; rel="canonical"Канонический URL должен быть абсолютным и находиться на том же домене. Для дублей, которые нужно полностью скрыть, чище использовать редирект 301. Следите за тем, чтобы карта сайта и внутренние ссылки указывали на один и тот же URL.
Статус «Обнаружена, не проиндексирована»
Это отдельный статус в Google Search Console, который означает: Google знает о URL, но ещё не скачивал страницу. Отличие от «просканирована, не проиндексирована» принципиальное: во втором случае краулер уже посещал адрес и отложил решение, в первом — ждёт своей очереди или не считает URL приоритетным.
Для PDF в статусе «Обнаружена» стандартная рекомендация — убедиться в наличии качественных входящих ссылок на файл и чёткого упоминания в карте сайта. Повторные отправки через Search Console ускоряют решение, но не меняют решение алгоритма о ценности страницы.
Ссылочный контекст вокруг PDF
Поисковик лучше индексирует и ранжирует PDF, на который ссылаются с тематически близких HTML-страниц. Опишите содержимое документа на HTML-странице и дайте ссылку с понятным анкором. Это помогает и пользователю решить, стоит ли открывать файл, и краулеру понять контекст.
Если PDF дублирует HTML-страницу, определитесь, какую версию хотите видеть в выдаче. Для PDF можно установить canonical на HTML-страницу через HTTP-заголовок — тогда в индекс попадёт HTML, а не файл. Убедитесь, что карта сайта и внутренние ссылки не противоречат этому выбору.
Как проверить индексацию списка PDF
Точечная проверка через инструмент проверки URL в Search Console показывает статус одного адреса и позволяет запросить повторное сканирование. Для списка документов ручная проверка неудобна: оператор site: в Google неполный, а оператор url: в Яндексе может не показывать все проиндексированные адреса.
Для массовой сверки пригодится проверка индексации в Google — загружаете список URL и получаете статус по каждому адресу с тайтлом, под которым страница находится в выдаче. Несовпадение тайтла с текущим заголовком документа означает, что в индексе лежит старая версия файла.
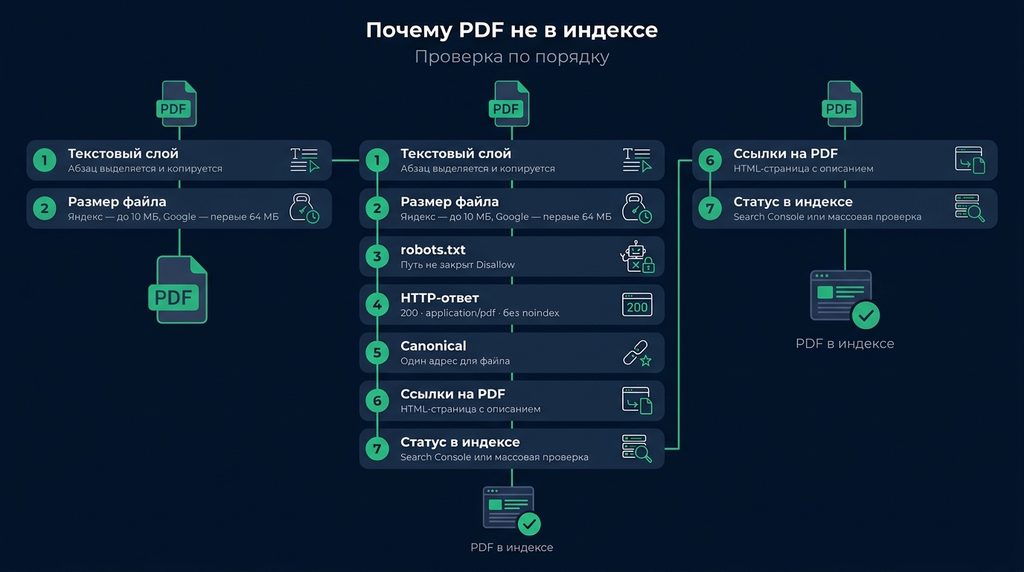
Чек-лист: порядок проверки
- Текстовый слой — выделение абзаца должно давать читаемый текст.
- Размер файла — не превышает 10 МБ.
- robots.txt — путь к файлу не закрыт директивой
Disallow. - HTTP-ответ — код 200, тип
application/pdf, нетX-Robots-Tag: noindex. - Canonical — один предпочтительный URL, карта сайта и ссылки согласованы.
- Ссылочный контекст — HTML-страница с описанием и ссылкой на файл.
- Проверка статуса — Search Console или массовая сверка списка.
Частые вопросы
Нужно ли добавлять PDF в sitemap? Желательно — это сигнал поисковику, что файл важен. Тип содержимого для PDF в sitemap не требует специальных атрибутов, достаточно стандартного тега <loc>.
Влияет ли атрибут download у ссылки на индексацию? Нет. Атрибут download меняет поведение браузера, но не влияет на краулер — он скачивает URL напрямую.
Почему PDF пропал из выдачи после обновления? Проверьте, не появился ли X-Robots-Tag: noindex после деплоя. Также убедитесь, что URL не изменился и старая версия не осталась доступной — иначе поисковик мог переключиться на другой адрес.
Помогает ли ускоренная индексация? Для документов, которые технически доступны, но зависли в очереди, ускоренная отправка сокращает время ожидания. SpeedyIndex работает со страницами и документами — загрузите список URL и проверьте, изменился ли статус на следующей сверке.