
Список URL к индексации готовится в четыре прохода: выгрузить адреса из sitemap (включая дочерние карты), убрать всё, что не отдаёт чистый 200, убрать всё, что закрыто noindex или robots.txt, и отделить уже проиндексированное от того, что ещё ждёт своей очереди. На выходе — текстовый файл, в котором каждый адрес заслужил место. Именно его отправляют на индексацию, а не «весь sitemap».
Звучит просто. На практике заметная часть списков, которые к нам приходят (оценка команды), собрана по принципу «скачал карту, отправил всё». Внутри — пагинация, страницы с 301, товары, снятые с продажи год назад, и разделы, которые сам же владелец закрыл noindex. Каждый такой адрес — либо отказ поисковика, либо впустую потраченные токены и лимиты.
Ниже — рабочий порядок из девяти шагов. У каждого есть инструмент, наблюдаемый выход и картина провала: вы знаете, что должно получиться, и видите, если получилось не то. Часть шагов делается бесплатными чекерами, часть — одной строкой в терминале. После такого пайплайна отчёт по индексации читается без гаданий: отказ алгоритма и мусор в списке больше не смешиваются.
Однако надо сразу понять, что чистый список повышает долю адресов, которые дошли до индекса, но не гарантирует индексацию: финальное решение принимает алгоритм Google или Яндекса.
Готовый список убирает ваши ошибки. Ошибки поисковика он не отменяет.
Sitemap — это не список к индексации, а сырьё для него
Миф: «положил URL в sitemap — поисковик обязан его проиндексировать». Это не так, и Google говорит об этом прямо. Sitemap — рекомендация о том, какие страницы вы считаете важными; сканировать и индексировать их поисковик не обязан.
Пересказ справки Google «Build and submit a sitemap» (Search Central, обновление 2026): один файл карты — не больше 50 000 URL и 50 МБ без сжатия, для больших сайтов используется sitemap index; в карте перечисляются только канонические адреса; значения
<priority>и<changefreq>Google игнорирует, а<lastmod>учитывает, только если дата стабильно и проверяемо соответствует реальному изменению страницы.
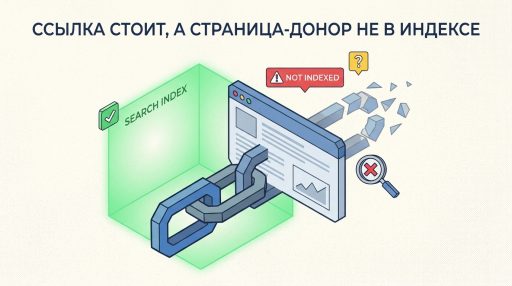
Точнее смотреть на карту сайта иначе: это заявка, а не приказ. Сгенерировал её плагин CMS, и он же положил туда всё, до чего дотянулся: архивы по датам, страницы авторов, фильтры каталога, черновики с noindex. Доказательство — в любом отчёте GSC «Страницы»: секция «Не проиндексированы» с причинами «Страница с переадресацией», «Не найдено (404)», «Исключена тегом noindex» почти всегда наполнена адресами именно из sitemap.
Отсюда и порядок работы: раз sitemap — сырьё, его просеивают. Сначала выгрузить, потом отфильтровать, потом проверить, что из оставшегося уже в индексе.
Во что обходится список без фильтра
Тезис: каждый лишний URL в задаче на индексацию — прямые потери. У любого сервиса индексации есть цена за адрес, у Google Indexing API — суточная квота, у Яндекс Вебмастера — дневной лимит переобхода. Отправили 1 000 адресов, из которых 300 отдают 404 или закрыты noindex, — треть квоты сгорела ни на что.
Антитезис: «У меня Pay-per-Result, за непроиндексированное вернут токены — зачем фильтровать?» Возврат закрывает финансовую сторону, но не временну́ю: отчёт замусорен ошибками, и в статистике «сколько реально зашло» вы не отличите отказ поисковика от собственных 404.
Команда SpeedyIndex: «Самый частый вопрос в поддержке — „почему из 2 000 ссылок в индекс попало 400″. Когда мы открываем задачу, в 6 случаях из 10 (внутренняя оценка команды, не измеренная статистика) половина списка ещё до отправки была нежизнеспособна: редиректы на другие адреса, снятые страницы, дубли с параметрами. Пре-чек их отсёк, но человек этого не заметил и решил, что индексация „не работает»».
Вывод: фильтр по кодам и директивам не ловит содержательные причины отказа — тонкий контент, дубли по смыслу, отсутствие внутренних ссылок. После подготовки списка любой невход в индекс — уже вопрос к странице, а не к пайплайну. Это единственная причина тратить на подготовку час.
Девять шагов: от sitemap до файла, который можно отправлять
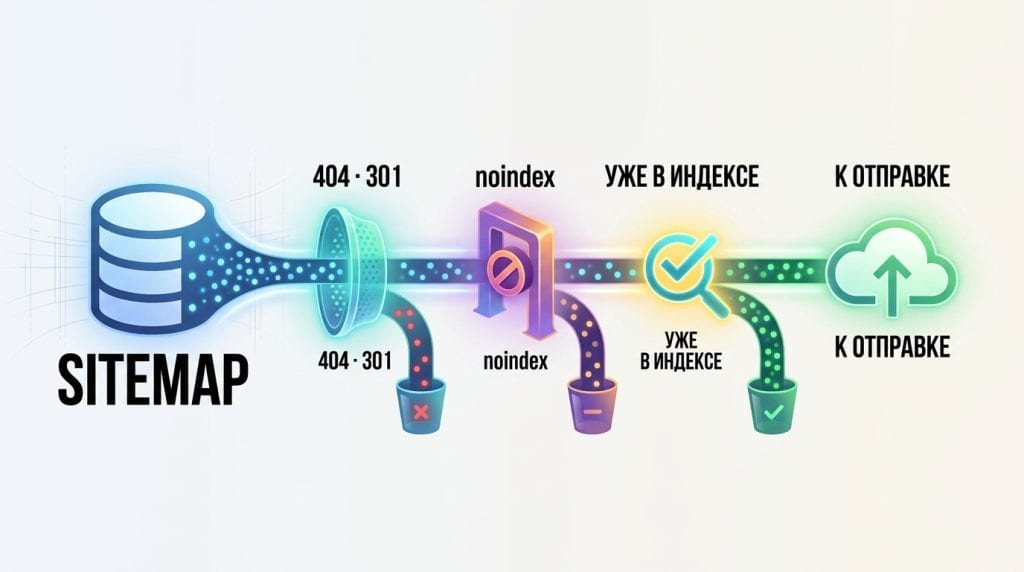
Шаг 1. Выгрузите адреса из sitemap и посчитайте их. Откройте карту в браузере и определите, что перед вами: <urlset> со страницами или <sitemapindex>, который ссылается на дочерние карты.
Инструмент — бесплатный парсер XML-карты сайта: вставляете адрес карты, получаете текстовый список по одному URL в строке. Кто работает в терминале — одна команда:
curl -s https://site.ru/sitemap.xml | grep -oP '(?<=<loc>)[^<]+' > raw.txt
wc -l raw.txt
Если это sitemap index, grep вернёт адреса дочерних карт, а не страниц — каждую раскрывайте отдельно, сжатые .xml.gz — через gunzip -c.
Что вы увидите: файл raw.txt и число строк из wc -l. Смотрите сразу.
Успех — число строк равно числу <loc> в карте (или сумме по дочерним картам), внутри нет тегов и пустых строк.
Провал — ноль строк или ошибка XML в браузере: карта отдаёт HTML-заглушку, 404 или неэкранированный &. Тогда чините карту, дальше идти не с чем.
Шаг 2. Нормализуйте список. Уберите дубли, разнобой протокола и хоста, хвосты параметров. Инструмент — sort -u и grep:
sort -u raw.txt > clean.txt
wc -l clean.txt
grep -c '^http://' clean.txt
grep -c '?' clean.txt
Настройка: если сайт живёт на https:// без www, в списке не должно быть ни одного http:// и ни одного www. — приведите sed-заменой.
Что вы увидите: три числа. Смотрите сразу.
Успех — строк стало меньше или столько же, http:// — ноль, адресов с ? — ноль или только те, где параметр создаёт отдельную страницу (пагинация, если она канонична).
Провал — в карте смешаны хосты: значит, генератор берёт адреса из разных источников, и чекер индексации потом посчитает www и без www разными страницами. Сначала решите, какой хост канонический, потом двигайтесь дальше.
Шаг 3. Прогоните коды ответа — без автоследования редиректов.
Инструмент — бесплатные чекеры 404 и 5xx или curl с мобильным User-Agent, потому что сканирует Googlebot Smartphone:
while read u; do
  curl -s -o /dev/null -A 'Mozilla/5.0 (Linux; Android 10; Mobile)' -w "%{http_code} $u %{redirect_url}\n" "$u"
done < clean.txt > codes.txt
Настройка — без ключа -L: вам нужен код первого ответа, а не конечного. Наблюдаемый выход: codes.txt со строкой «код, URL, адрес редиректа». Смотрите сразу; строки с 5xx перепроверьте через час — сервер мог быть перегружен.
Успех — 200 и пустое поле редиректа.
Провал делится на четыре диагноза с разными действиями: 404/410 — в отдельный файл и вон из sitemap; 301/302 — в список кладём конечный адрес из третьего столбца, а исходный выбрасываем (301 — это не «почти 200», для индексации существует только конечный URL); 5xx — отложить до стабильного ответа; 403 при 200 в браузере — антибот-фильтр режет запросы без cookies, поисковый краулер получит то же самое, разбирайтесь с файрволом.
Шаг 4. Отловите soft 404. Код 200 — ещё не признак живой страницы: снятый товар или удалённая запись часто отдают 200 и текст «ничего не найдено».
Инструмент — curl и размер ответа:
while read u; do printf '%s %s\n' "$(curl -s "$u" | wc -c)" "$u"; done < ok.txt | sort -n | head -30Настройка: ok.txt — только адреса с 200 из шага 3. Наблюдаемый выход: 30 самых коротких страниц по байтам. Смотрите сразу.
Успех — самые короткие страницы всё равно содержат основной контент (откройте три-четыре руками).
Провал — в начале списка страницы весом в шаблон: заголовок «Не найдено», пустой каталог, «Товар снят с продажи». Это soft 404: из списка убираем, а на сайте либо отдаём честный 404/410, либо возвращаем контент. GSC такие страницы позже покажет как «Ошибка soft 404», и лучше найти их раньше отчёта.
Шаг 5. Проверьте noindex — и сразу robots.txt.
Инструмент — бесплатный чекер noindex или две строки curl: одна на заголовок X-Robots-Tag, другая на мета-тег:
curl -sI "$u" | grep -i 'x-robots-tag'
curl -s "$u" | grep -io '<meta[^>]*name="robots"[^>]*>'
Что вы увидите: строка с noindex/none либо пустой вывод. Смотрите сразу.
Успех — вывод пуст по обеим проверкам.
Провал — есть noindex: адрес из списка убираем; если директива стоит по ошибке, снимаем её и ждём переобхода, а не отправляем «пока так».
Граничный случай, который ломает этот шаг: путь закрыт Disallow в robots.txt. Тогда чекер честно скажет «noindex нет», но поисковику это не поможет — по справке Google о блокировке индексирования директива noindex работает только на странице, доступной для сканирования; закрытый robots.txt адрес Googlebot не откроет и noindex не увидит. Поэтому отдельно откройте https://site.ru/robots.txt и сверьте правила Disallow с путями из списка. Закрытые адреса в задачу не идут, пока правило не снято.
Шаг 6. Сверьте canonical. Страница может отдавать 200 и при этом указывать каноническим другой адрес — поисковик проиндексирует тот, другой.
Инструмент — curl и grep:
curl -s "$u" | grep -io '<link[^>]*rel="canonical"[^>]*>'Что вы увидите: тег с href. Смотрите сразу.
Успех — href побайтно совпадает с проверяемым URL.
Провал — href ведёт на другой адрес: в список кладём канонический (после того как он сам прошёл шаги 3–5), исходный выбрасываем. href на другой хост или на http:// — возвращайтесь к шагу 2, у сайта нерешённый вопрос с зеркалом.
Шаг 7. Отделите уже проиндексированное. Сюда доходит список из адресов с 200, без noindex, с совпадающим canonical. Теперь его делят надвое.
Инструмент — массовая проверка индексации в Google по файлу (для Яндекса и Bing — отдельные режимы) либо «Проверка URL» в Search Console для контрольной выборки: GSC проверяет по одному адресу и только на подтверждённом сайте, для сотен строк не годится.
Настройка: загрузите файл, выберите поисковик.
Что вы увидите: постатусный список «в индексе / не в индексе» с экспортом. Смотрите после завершения проверки — минуты.
Успех — два файла: indexed.txt и to-index.txt.
Провал — расхождения. site: в поиске не нашёл, а чекер говорит «в индексе»: верьте чекеру, site: показывает не всё. Чекер говорит «не в индексе», а в GSC статус «Проиндексирована»: страница могла быть проиндексирована под каноническим адресом — сверьте поле «Канонический URL, выбранный Google» в «Проверке URL».
Шаг 8. Соберите задачу и отправьте только to-index.txt. Параллельно вычистите из sitemap всё, что отсеялось на шагах 3–6: карта, в которой лежат 404 и noindex, каждым переобходом напоминает поисковику о ваших ошибках.
Инструмент — веб-кабинет SpeedyIndex или Telegram-бот: новая задача, файл со списком.
Настройка: режим Standard для разовой отправки (до 100 000 адресов файлом) или Drip-Feed, если адреса должны уходить порциями по часам и дням; включите предварительную проверку ссылок — она страхует от того, что вы всё-таки пропустили (404/410/451, noindex, robots.txt, медиафайлы, уже проиндексированные URL), и токены за отсечённые адреса не сгорают.
Что вы увидите: диалог подтверждения с числом URL и итоговым списанием. Смотрите до нажатия «Отправить».
Успех — число URL в диалоге равно числу строк в to-index.txt.
Провал — число меньше: пре-чек нашёл то, что вы пропустили. Откройте список отсечённых и разберитесь, какой шаг пайплайна дал течь, прежде чем подтверждать.
Шаг 9. Прочитайте отчёт, а не общий процент.
Инструмент — отчёт задачи в кабинете и, для своего сайта, отчёт «Страницы» в GSC либо «Страницы в поиске» в Яндекс Вебмастере. Когда смотреть: день 7 для Google, день 15 для Яндекса.
Что вы увидите: три группы — проиндексированные (с тайтлами страниц), непроиндексированные, ошибки индексации вида «Страница просканирована, но пока не проиндексирована»; токены за непроиндексированные адреса вернулись на баланс.
Успех — в группе «непроиндексированные» нет адресов с 404, редиректами и noindex: раз список был чистый, каждый невход — решение алгоритма.
Провал — статус «просканирована, но не проиндексирована» у большой доли: это не сбой пайплайна и не повод сразу переотправлять.
Проверьте контент, дубли по смыслу и внутренние ссылки, дайте странице 2–3 недели и повторите проверку индекса.
Чем выгружать и проверять: пять способов и их пределы
| Метод | Кому подходит | Ожидаемая скорость | Риск | Когда НЕ использовать |
|---|---|---|---|---|
| Парсер XML-карты онлайн | Владельцу сайта и SEO без терминала; для чужих доменов и доноров | Секунды на карту | Не раскроет sitemap index без отдельного запуска по каждой дочерней карте | Когда карта закрыта авторизацией или отдаётся только по IP-белому списку |
curl + grep + sort -u | Техническому специалисту, для регулярного повтора по cron | Минуты на 10–50 тыс. строк | Ошибки регулярного выражения на нестандартном XML; gz и index надо разворачивать руками | Если нет доступа к консоли или список собирает не технический сотрудник |
| Screaming Frog, List mode | Агентству и аудиту сайта целиком | Минуты — часы, зависит от размера и лицензии | Бесплатная версия ограничена по числу URL; путается на антибот-фильтрах | Для 100 доноров и разовой задачи — избыточно |
| Экспорт отчёта «Страницы» из GSC | Владельцу подтверждённого сайта, для сверки с индексом | Сразу, но выгрузка таблицы ограничена по числу строк — это не «весь индекс» [VERIFY: текущий лимит экспорта по справке Search Console] | Показывает состояние на дату отчёта, не «сейчас»; чужие домены недоступны | Для доноров, PBN и любых сайтов без прав в GSC |
| Массовая проверка индексации по файлу | Линкбилдеру и всем, у кого список от 100 адресов, включая чужие домены | Минуты на тысячи URL | Статус — на момент проверки; страница под другим canonical может показаться «не в индексе» | Для одного-двух своих адресов — проще «Проверка URL» в GSC |
Где ломается пайплайн: четыре типовых сбоя
Sitemap index выгружен как список страниц.
Факт: у сайтов от нескольких тысяч страниц CMS обычно отдаёт sitemap.xml как индекс дочерних карт.
Связь: grep по <loc> честно даёт 5–20 адресов — адреса карт.
Утверждение: «у нас в sitemap всего 12 страниц».
Опровержение: откройте любой из адресов — это ещё один XML; пайплайн стартует заново с каждой дочерней карты.
Редиректы посчитаны за живые страницы.
Факт: curl -L и большинство браузерных проверок показывают конечный 200.
Связь: в список попадает исходный адрес с 301.
Утверждение: «страница отвечает 200, всё хорошо».
Опровержение: для индексации существует конечный URL, исходный поисковик пометит как «Страница с переадресацией» и в индекс не возьмёт. В список идёт третий столбец из шага 3, а не первый.
Чекер noindex сказал «чисто», а GSC — «Заблокировано в robots.txt».
Факт: путь закрыт Disallow.
Связь: Googlebot страницу не открывал, содержимое <head> не читал.
Утверждение: «noindex нет, значит, индексируемо».
Опровержение: по справке Google директивы на странице работают только там, куда краулер может зайти; статус в GSC покажет именно блокировку robots.txt, а не noindex. Проверка robots.txt — обязательный спутник шага 5, а не «если время останется».
Отправлено 2 000, в индекс вошло 400 — «сервис не работает».
Факт: отчёт день 7 показывает 400 проиндексированных, остальное — непроиндексировано или «просканирована, но не проиндексирована».
Связь: список не проходил шаги 3–7.
Утверждение: «индексация не сработала».
Опровержение: разложите непроиндексированные по кодам и директивам — по опыту поддержки (оценка команды, не измеренная статистика) от трети до половины адресов нежизнеспособны ещё до отправки. Оставшийся отказ — вопрос к страницам, и решается он на сайте.
Иллюстративная модель: каталог на 8 000 адресов после переезда
Иллюстративная модель на основе типичных условий для команды из e-commerce; цифры — диапазоны и допущения, не измеренные результаты реального клиента.
Контекст. Интернет-магазин переехал на новую CMS. Sitemap — индекс из шести дочерних карт, суммарно около 8 000 адресов. Задача: понять, что отправлять на индексацию.
До. Список выгружен «как есть» и отправлен целиком. По ощущениям команды в индекс зашла «примерно половина», отчёт замусорен: сотни 404 по снятым товарам, 301 со старых адресов на новые, фильтры каталога с параметрами. Где отказ поисковика, а где собственный мусор, неясно.
Действия. Раскрыты все шесть карт; после sort -u и приведения хоста список сжимается на 10–15 % (оценка: дубли с www и параметрами). Без -L видны 301 — заменены конечными адресами; 404 удалены из карт; заглушки снятых товаров с 200 отловлены по размеру; категории под Disallow от старой CMS открыты до отправки. Массовая проверка делит остаток на «в индексе» и «к отправке», в задачу уходит только второй файл с включённой предварительной проверкой.
После. Список к отправке сократился примерно до 40–60 % от исходных 8 000 (диапазон, не измерение). На день 7 среди непроиндексированных нет ни одного 404 и редиректа — только страницы, по которым вопрос к контенту. Смоделированный провал: одна дочерняя карта была .xml.gz, первый прогон её пропустил; заметили по расхождению числа строк с числом <loc> в index-файле. Урок: считать строки на каждом шаге.
Вывод. Пайплайн не ускорил индексацию сам по себе — он убрал из задачи всё, что и не могло попасть в индекс, и оставил в отчёте только настоящие отказы.
Вопросы, которые остаются после чек-листа
В: Как выгрузить все URL из sitemap, если это sitemap index?
О: Сначала соберите адреса дочерних карт из <sitemapindex>, затем прогоните парсер или curl по каждой из них и склейте результат. Сжатые карты .xml.gz разворачивайте gunzip -c. Итоговое число строк должно сходиться с суммой <loc> по всем дочерним картам.
В: Нужно ли удалять из sitemap страницы с 404?
О: Да. По справке Google в карте перечисляются только канонические рабочие адреса; 404, 410 и редиректы в ней — шум, который каждый переобход тратит зря. Удаляйте из карты и не кладите в список к отправке.
В: Как проверить noindex по списку URL массово?
О: Бесплатным чекером noindex по файлу или curl: заголовок X-Robots-Tag через -I, мета-тег robots — через grep по HTML. И отдельно сверьте пути с Disallow в robots.txt — иначе проверка noindex даёт ложное «чисто».
В: Как массово проверить индексацию страниц в Google перед отправкой?
О: Загрузите подготовленный файл в инструмент массовой проверки индексации, выберите поисковик и экспортируйте результат: два списка — «в индексе» и «не в индексе». site: для этого не подходит: он не показывает всё, что в индексе, и даёт ложные «нет».
В: Что делать со статусом «Просканирована, но пока не проиндексирована» в отчёте?
О: Не переотправлять сразу. Если список был чистый, это решение алгоритма о странице: проверьте контент, дубли по смыслу, внутренние ссылки, дайте 2–3 недели и повторите проверку индекса. Повторная отправка без правок расходует лимиты ещё раз.
Куда движется подготовка списков и что можно сделать за 10 минут
Факт: отправка на индексацию уходит в API и пакетные задачи — Indexing API с квотами, IndexNow, API сервисов индексации.
Категоризация: чем быстрее сама отправка, тем дороже мусор в списке — квота сгорает за секунды.
Оценка: наше информированное мнение на 2026–2028 — фильтр по кодам, директивам и статусу в индексе станет обязательным слоем перед любым API-вызовом, а не «хорошей практикой».
План на 10 минут: откройте свой sitemap.xml, определите, urlset это или index, выгрузите адреса и посчитайте строки. Затем grep -c '^http://' и grep -c '?'. Два числа отличных от нуля — и вы уже нашли, с чего начинать. Останется прогнать коды ответа и разделить список тем же инструментом массовой проверки индексации, что в шаге 7: он работает по любым доменам и без прав в Search Console.
Что SpeedyIndex делает с вашим списком и где заканчивается его зона ответственности
Что нужно на входе. Список адресов: текстовый файл или строки в кабинете, до 100 000 URL в режиме Standard. Подтверждать права на домен в GSC или Вебмастере не нужно — принимаются любые сторонние адреса: беклинки, гостевые посты, PBN, крауд, Tier-2/3.
Что сервис проверяет до списания. Опция предварительной проверки ссылок отсекает HTTP 404/410/451, страницы под robots.txt и noindex, медиафайлы и уже проиндексированные URL. Токены за отсечённые адреса не сгорают. Бесплатные инструменты — парсер XML-карты, чекеры редиректов, noindex, 404 и 5xx — закрывают шаги 1, 3 и 5 этой статьи без входа в кабинет.
Как считаются деньги. Модель Pay-per-Result: токены списываются только за проиндексированные ссылки, 1 проиндексированный URL — 100 токенов. Проверка на 7-й день для Google и на 15-й для Яндекса; за непроиндексированные адреса токены автоматически возвращаются на баланс. Новым пользователям — 200 бесплатных токенов на пробу.
Что вы получаете на выходе. Отчёт день 7 / день 15: проиндексированные страницы с тайтлами, непроиндексированные, ошибки вида «Страница просканирована, но пока не проиндексирована». Режим Drip-Feed растягивает отправку по часам и дням, если нужен ровный темп; интерфейсы — веб-кабинет, Telegram-бот, расширение Chrome и API [API-DOC: детали эндпоинтов только из приложенной документации].
Чего сервис не гарантирует. Индексацию. Краулер — Googlebot Smartphone, отправка и проверка — на нашей стороне, решение — на стороне алгоритма. Чистый список из этой статьи повышает долю адресов, за которые вообще есть смысл платить; остальное решает поисковик.