
Ссылка, которую вы видите в браузере, для Google не существует, пока страница-донор не попала в индекс. Отчёт от биржи, скриншот от вебмастера, строка в Ahrefs — всё это подтверждает факт размещения, а не факт индексации. Проверять нужно не ссылку, а URL донора: код ответа под мобильным Googlebot, директивы noindex и robots.txt, canonical, наличие тега <a> в сыром HTML и только потом — статус в индексе Google и Яндекса.
Кратко о том «как проверить индексацию обратных ссылок»: соберите список URL доноров, снимите с каждого HTTP-статус и директивы, прогоните список через массовый чекер индексации, сверьте результат с отчётом «Ссылки» в Search Console, а тех доноров, которых в индексе нет, отправьте на индексацию и дождитесь отчёта на 7-й день. По отдельности ни одна из этих проверок ничего не доказывает — ответ даёт только вся последовательность целиком.
Ниже — десять шагов с конкретным результатом, разбор четырёх ловушек, в которые попадают даже опытные линкбилдеры, и честный список того, что ни один сервис не может гарантировать.
Почему «ссылка стоит» и «ссылка работает» — разные события
Миф: разместили, увидели в браузере, оплатили — значит, ссылка передаёт вес. В 2010-х это почти работало: Google индексировал агрессивно, форумные и профильные страницы залетали в индекс за пару дней, а проверка сводилась к оператору site:. Публикация 2011 года на alaev.info с проверкой 340 постовых ссылок показательна тем, что автор уже тогда проверял не ссылки, а страницы-доноры на индексацию — и делал это вручную.
Переосмысление пришло вместе с выборочной индексацией. Статус «Страница просканирована, но пока не проиндексирована» в Search Console стал обычным делом для страниц с минимумом контента, а форумные ветки, каталоги и профили — первыми кандидатами на вылет. Ссылка на такой странице формально есть, а для алгоритма её нет.
Доказательство лежит в официальной документации. Справка Google по отчёту «Ссылки» в Search Console прямо говорит: отчёт включает ссылки, которые Google нашёл когда-либо, и часть из них уже могла исчезнуть вместе со страницей; итоговые цифры над таблицами могут не учитывать непроиндексированные страницы; пометку nofollow отчёт не показывает (Справка Search Console, статья «Отчёт о ссылках»). То есть даже единственный официальный источник данных о беклинках не отвечает на вопрос «донор в индексе?».
Документация Google по оператору
site:предупреждает: оператор не обязан возвращать все URL, проиндексированные под указанным префиксом, и без дополнительного запроса не ранжирует результаты (developers.google.com, раздел Search operators, страница проsite:).
Джон Мюллер, Google, в выпуске Ask Googlebot (2021, цитируется по Search Engine Journal : запрос
site:«не предназначен быть полным и не годится для диагностики».
Отсюда подводка: проверка индексации обратных ссылок — это не один запрос, а протокол из технических и поисковых проверок, где каждый шаг отсекает свою причину неудачи.
Что теряет бизнес, когда доноры висят вне индекса
Тезис: непроиндексированный донор — это оплаченная ссылка с нулевым эффектом. Бюджет на гостевой пост, крауд или аутрич списан, а ссылочный профиль в глазах алгоритма не изменился. По отраслевым оценкам линкбилдеров, доля доноров, которые не попадают в индекс без дополнительных действий, обычно лежит в диапазоне 20–40 % для крауд-ссылок и профилей и заметно ниже для гостевых постов на живых медиа (оценка, не измерение).
Антитезис: часть доноров индексируется сама через 2–6 недель. Это верно для сайтов с регулярным обходом; для «тонких» форумных страниц третьего уровня вложенности ожидание чаще заканчивается ничем.
Ограничение: даже успешная индексация донора не гарантирует передачу веса. Google может проиндексировать страницу и одновременно обесценить ссылку как неестественную — и никакой чекер этого не покажет. Здесь заканчивается зона наблюдаемого и начинается зона алгоритма.
Команда SpeedyIndex: «Клиенты часто присылают нам список ссылок с вопросом „почему не выросли позиции». Мы просим прогнать те же URL через чекер индексации — и в типичной выгрузке треть доноров ни разу не была в индексе Google. Не потому, что ссылки плохие. Потому, что их никто не проверял после размещения».
Диагностический вывод: сначала отделите доноров вне индекса от доноров в индексе. Только для первой группы имеет смысл что-то предпринимать. Для второй вопрос «почему нет эффекта» — это уже вопрос о качестве донора, а не об индексации.
Десять шагов: от списка доноров до отчёта на 7 день
Шаг 1. Нормализуйте список доноров. Выгрузите URL страниц-доноров из отчёта биржи, таблицы аутрича или экспорта Ahrefs в одну колонку таблицы. Приведите каждый адрес к абсолютному виду с протоколом, без #якорей и без UTM-параметров, которые добавил трекер биржи.
Смотрите результат сразу: одна строка — один URL, дубли http/https и www/без www схлопнуты. Если в списке остались адреса вида site.ru/thread?page=3#post-1234, чекер проверит страницу целиком, а якорь только запутает сверку — режьте до ?page=3.
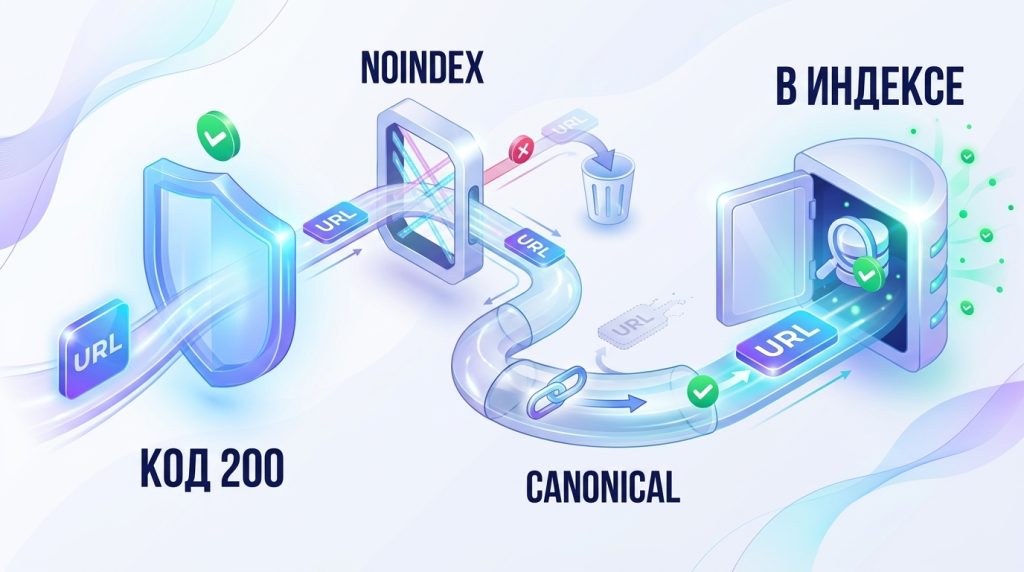
Шаг 2. Снимите код ответа под мобильным Googlebot. В терминале выполните запрос с заголовком User-Agent мобильного краулера:
curl -sI -A "Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/125.0 Mobile Safari/537.36 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)" https://donor.example/thread/123В норме — HTTP/2 200 без заголовка X-Robots-Tag: noindex.
Проблема: бывает трёх видов.
301 или 302 с полем Location означает, что в индекс пойдёт конечный URL, а не тот, который вы оплатили, — берите адрес из Location и начинайте шаг заново с него.
403 или 503 только под ботом при 200 в браузере — антибот-защита хостинга: донор недоступен для краулера, и ссылка не будет прочитана.
404 или 410 — страница удалена; в кампанию по индексации такой URL не кладут, а идут к владельцу площадки.
Шаг 3. Проверьте директивы индексации донора. Скачайте HTML и отфильтруйте мета-роботс, затем откройте robots.txt площадки:
curl -sL https://donor.example/thread/123 | grep -io '<meta[^>]*name="robots"[^>]*>'
curl -s https://donor.example/robots.txt | grep -i -B1 -A5 "Googlebot\|User-agent: \*"
В норме — grep вернул пустоту или content="index, follow", а в robots.txt нет Disallow, накрывающего путь донора.
Проблема: возможны два тревожных сценария
content="noindex" в мета-теге или в заголовке X-Robots-Tag — страница не будет проиндексирована ни при каких условиях, пока владелец не снимет директиву; Disallow: /thread/ в robots.txt — краулер не скачает HTML и не увидит вашу ссылку, даже если сам URL мелькнёт в выдаче без описания.
Оба случая — не «попробуем отправить», а «пишем вебмастеру или меняем донора». Для списка из сотен URL те же проверки делает бесплатный noindex-чекер.
Шаг 4. Найдите канонический адрес. В том же скачанном HTML найдите тег <link rel="canonical">.
В норме — href совпадает с URL донора с точностью до слеша.
Проблема — canonical указывает на другой адрес (первую страницу ветки, версию без параметров, мобильный поддомен). Google проиндексирует каноническую версию, поэтому проверьте, что ваша ссылка есть и на ней. Если на канонической странице ссылки нет, донор для вас не существует независимо от статуса индекса.
Шаг 5. Убедитесь, что тег ссылки есть в сыром HTML. Отфильтруйте скачанную страницу по вашему домену:
curl -sL https://donor.example/thread/123 | grep -io '<a [^>]*href="[^"]*vash-sait\.ru[^"]*"[^>]*>'В норме — строка с тегом <a href="https://vash-sait.ru/..."> и её атрибутами. Обратите внимание на rel: nofollow, ugc или sponsored не мешают индексации донора, но меняют то, как Google трактует ссылку.
Проблема — пустой вывод при том, что в браузере ссылка видна: её дорисовывает JavaScript, и без рендеринга краулер её не найдёт.
Или — ссылку удалили или заменили модераторы. Массово это проверяет инструмент «Проверка наличия ссылок» на blog.speedyindex.com.
Шаг 6. Сделайте точечную проверку операторами. Для Google введите site: с полным URL донора и одним словом из его заголовка — документация Google описывает именно такую форму как способ узнать, проиндексирован ли конкретный URL по термину.
Для Яндекса используйте url:donor.example/thread/123.
В норме — сниппет донора в выдаче.
Проблема — пустая выдача. И здесь главная ловушка: пустой site: — сигнал, а не приговор. Тот же документ Google оговаривает, что оператор возвращает не все проиндексированные URL. Поэтому одиночный минус переносим в шаг 7, а не в таблицу «не в индексе».
Шаг 7. Прогоните список через массовый чекер индексации. Загрузите нормализованный список в проверку индексации страниц в Google — тот же инструмент есть для Bing и Яндекса.
Настройка: одна поисковая система на запуск, весь список целиком. Через несколько минут вы увидите таблицу со статусом по каждому URL — проиндексирован или нет — и тайтлом, под которым страница сидит в выдаче.
В норме — статус «проиндексирован» и тайтл, совпадающий с заголовком донора.
Проблема — «не проиндексирован» у URL, которые прошли шаги 2–5. С этим списком переходите к шагу 9.
Обратите внимание ещё на одну деталь: если тайтл в отчёте отличается от того, что сейчас стоит на странице, значит, у Google в индексе лежит старая копия — и вашей ссылки в ней может ещё не быть.
Шаг 8. Сверьтесь с отчётом «Ссылки» в Search Console. В своём ресурсе откройте «Ссылки» → «Внешние ссылки» → «Экспорт» → срез «Последние ссылки». Смотрите через 1–3 дня после размещения, потом на 14-й день.
В норме — URL донора в выгрузке с датой обнаружения: Google видел страницу и нашёл на ней ссылку.
Проблема — донора нет. Но читайте этот отчёт с двумя поправками из документации: в нём остаются ссылки со страниц, которые уже могли выпасть из индекса, и он не показывает nofollow. Значит, присутствие в отчёте подтверждает обнаружение, а не текущий индекс. Отсутствие не означает, что донора нет в индексе — отчёт отстаёт на дни, а 21 мая 2026 года, по данным Search Engine Roundtable, он и вовсе показывал нули или резкое падение у массы сайтов, пока Google не подставил цифры недельной давности. Проверку URL для донора применить нельзя: инструмент проверки URL работает только для страниц вашего подтверждённого ресурса.
Шаг 9. Отправьте непроиндексированных доноров на индексацию. Список из шага 7 загрузите задачей в кабинет SpeedyIndex: режим Standard для пакета до 100 000 URL списком или файлом, Drip-Feed — если хотите растянуть отправку по дням для молодой сетки.
Включите предварительную проверку: она отсечёт 404/410/451, страницы под robots.txt и noindex, медиафайлы и уже проиндексированные URL, чтобы токены не сгорели на мусоре. Перед запуском вы увидите диалог подтверждения с итоговым списанием.
Смотрите отчёт на 7 день для Google и на 15 день для Яндекса.
В норме— URL в разделе проиндексированных с тайтлом страницы.
Проблема — URL в разделе непроиндексированных или с ошибкой «Страница просканирована, но пока не проиндексирована»; токены за него вернулись на баланс по модели Pay-per-Result. Такой донор после чистого прохода шагов 2–5 и отправки — кандидат на замену: вопрос уже не в доставке краулера, а в том, что алгоритм не считает страницу достойной индекса.
Шаг 10. Поставьте повторную сверку на 30-й день. Доноры выпадают из индекса: модераторы чистят ветки, площадки меняют структуру, малосодержательные страницы не переживают повторную оценку и выпадают из индекса.
Прогоните тот же список через массовую проверку беклинков — она покажет DA, Spam Score, анкор и атрибут dofollow/nofollow/sponsored/ugc по каждому донору — и повторите шаг 7. Смотрите на 30-й день и далее ежемесячно.
В норме — две выгрузки совпадают или расходятся на пару процентов.
Проблема — донор, который был в индексе, из него ушёл; возвращайтесь к шагу 2 именно для него, потому что чаще всего причина — новый редирект или noindex, а не решение алгоритма.
Способ проверки для какой задачи
| Метод | Кому подходит | Ожидаемая скорость | Риск | Когда НЕ использовать |
|---|---|---|---|---|
Оператор site: / url: вручную | 1–20 доноров, разовая сверка | Секунды на URL | Ложный минус: оператор не показывает все проиндексированные URL | Для списков от 50 URL и для выводов «не в индексе» по одному минусу |
| Отчёт «Ссылки» в Search Console | Владелец акцептора с доступом к GSC | Лаг 1–7 дней | Показывает обнаружение, а не текущий индекс; не показывает nofollow; бывают сбои отчёта | Как единственный источник статуса донора |
| Проверка URL в Search Console | Только свои страницы | Секунды | Не принимает чужие URL | Для любого донора — инструмент не для этого |
curl + grep по HTML | Технический специалист, любой объём при скрипте | Секунды на URL | Не отвечает на вопрос об индексе, только о доступности и директивах | Как замена проверке индекса |
| Массовый чекер индексации | Списки от десятков до тысяч URL | Минуты на список | Снимок на момент проверки; статус может измениться завтра | Без нормализации списка — редиректы дадут ложные минусы |
| Отправка на индексацию с отчётом дня 7 / 15 | Доноры, прошедшие технические проверки | 7 дней Google, 15 дней Яндекс | Алгоритм может отказать; результат не гарантируется | Для URL с noindex, 404 и под Disallow — их сначала чинят |
Четыре ловушки, которые портят сверку
Ловушка 1: строка в Ahrefs или Semrush равна индексу Google.
Факт: сторонние краулеры строят собственный индекс ссылок.
Связь: они видят страницу, когда обходят её сами, независимо от Google.
Утверждение линкбилдера: «ссылка появилась в Ahrefs, значит, всё работает».
Опровержение: наличие в базе стороннего сервиса говорит о том, что его бот нашёл тег <a>, и ничего не говорит о решении Google. Статус индекса Google снимают только у Google — оператором или чекером, который парсит выдачу.
Ловушка 2: пустой site: — донор не в индексе.
Факт: документация Google называет оператор неполным.
Связь: пустая выдача по одному URL может быть свойством оператора, а не индекса.
Утверждение: «проверил site: — ноль, донор мёртв».
Опровержение: одиночный минус подтверждают вторым методом; расхождения между site: и реальным индексом — норма, о которой Google говорит открыто.
Ловушка 3: донор есть в отчёте «Ссылки» GSC — значит, ссылка учтена.
Факт: справка отчёта прямо пишет, что в нём остаются ссылки со страниц, которые могли исчезнуть.
Связь: отчёт накапливает историю, а не отражает текущее состояние индекса.
Утверждение: «Google видит ссылку, дальше можно не проверять».
Опровержение: отчёт подтверждает, что ссылка была обнаружена. Что с донором сегодня — покажет только свежая проверка индекса.
Ловушка 4: nofollow — причина неиндексации донора.
Факт: атрибут rel="nofollow" относится к ссылке, а не к странице.
Связь: страница с nofollow-ссылками индексируется так же, как любая другая.
Утверждение: «донор не в индексе, потому что ссылка nofollow».
Опровержение: причины неиндексации донора — noindex, robots.txt, редирект, слабый контент, отказ алгоритма. Атрибут ссылки влияет на то, как Google трактует переход, и не влияет на индексацию страницы, где ссылка стоит.
Три ситуации из практики
1 сценарий — не реальный клиент.
Линкбилдер агентства закупает 120 крауд-ссылок на форумах и в комментариях. Через две недели site: показывает пустоту по половине URL. Массовая проверка возвращает 71 проиндексированный из 120. Разница между ручной и массовой проверкой — 11 URL, которые оператор просто не показал.
Вывод: одиночный site: завышает потери.
2 сценарий — не реальный клиент.
Владелец интернет-магазина получил 15 гостевых постов. Все 200, все без noindex. Пять не в индексе через месяц. Проверка canonical показала: на трёх площадках канонический адрес ведёт на первую страницу категории, где ссылки нет.
Вывод: 200 и noindex — не полный чеклист; canonical проверяют отдельно.
3 сценарий — не реальный клиент.
Арбитражник ведёт сетку сателлитов и отправляет 400 URL Tier-2 на индексацию без предварительной проверки. Отчёт дня 7: 190 проиндексированных, 150 непроиндексированных, 60 с ошибками, среди них — редиректы на удалённые страницы. Токены за 210 URL вернулись, но неделя потеряна.
Вывод: предварительная проверка стоит меньше недели ожидания.
Условный пример: как B2B-сервис проверяет 300 доноров в месяц
Пример на основе типичных условий для команды линкбилдинга из ниши B2B SaaS. Все цифры — диапазоны или условные значения, не измеренные результаты реального клиента.
Ниша и контекст. Команда из двух человек ведёт аутрич и крауд для англоязычного SaaS. Ежемесячно появляется около 300 новых доноров: 60–80 гостевых постов, остальное — профили, каталоги, комментарии и Tier-2 на собственных сателлитах.
До. Проверка индексации — выборочная, site: по 20–30 адресам раз в месяц. Оценка доли доноров вне индекса — «где-то треть», без списка. Бюджет на замену неработающих ссылок не заложен, потому что неработающие не выявлены.
Действия. Список из 300 URL нормализован по шагу 1.
Скрипт на curl снял коды и директивы по шагам 2–5: примерно 8–12 % URL отсеяны как редиректы на другой адрес, noindex или страницы под Disallow. Оставшиеся прошли массовую проверку индекса. Не проиндексированные отправлены на индексацию с предварительной проверкой в режиме Drip-Feed на 5 дней. Отчёт на 7 день разобран, повторная сверка поставлена на 30-й день.
После. До отправки в индексе находилось 55–65 % доноров, после отчёта дня 7 — 80–90 %. Доля, за которую токены вернулись, — 10–20 %; эти доноры помечены на замену. Что пошло не так: 14 URL на одной форумной площадке проиндексировались, а через три недели выпали — площадка включила noindex для веток без ответов.
Таким образом: шаг 10 обязателен, а не опционален.
Вывод. Команда перешла от оценки «треть не в индексе» к списку конкретных URL с причиной по каждому. Это и есть результат протокола: не гарантия индексации, а управляемость.
«Обнаружена, не проиндексирована» у донора: что этот статус значит на самом деле
Отдельная ситуация — когда владелец площадки показывает вам скриншот Search Console со статусом «Страница обнаружена, но пока не проиндексирована» по URL донора. Это не то же самое, что «просканирована, но не проиндексирована». Обнаруженная страница ещё ни разу не скачана краулером: Google узнал адрес из ссылки или sitemap и отложил обход. Просканированная — скачана и отклонена на этапе отбора. Диагнозы разные, и действия разные.
Для «обнаруженной» страницы шаги 2–5 этого протокола особенно важны: краулер мог откладывать обход из-за медленного ответа сервера или слабой внутренней перелинковки раздела. Справка Search Console называет типичной причиной перегруженность сайта: Google планировал обход и перенёс его. Пока статус висит, ссылка на такой странице для алгоритма не существует — отправка донора на индексацию здесь решает ровно ту задачу, ради которой затевался весь протокол: доставить краулера на страницу, которую он сам обходить не торопится.
Если донор после отправки перешёл из «обнаружена» в «просканирована, но пока не проиндексирована» — это движение вперёд, а не отказ: страница скачана и ждёт решения алгоритма. Если же и через 30 дней статус не меняется, донор уходит в список на замену по шагу 10.
Ответы на частые вопросы
В: Как проверить, проиндексирована ли обратная ссылка, если у меня нет доступа к сайту донора?
О: Доступ не нужен. Проверяют публичный URL донора: код ответа, директивы, canonical, тег ссылки в HTML и статус в индексе через оператор или массовый чекер.
В: Проверка индексации ссылок в Яндексе отличается от Google?
О: Оператор другой — url: вместо site:, сроки другие — отчёт по отправке приходит на 15-й день вместо 7-го. Логика технических проверок одинаковая. Обход по счётчикам Метрики донору не поможет: он работает только для сайта с вашим счётчиком.
В: Индексация беклинков в Google — сколько ждать после размещения, прежде чем считать донора проблемным?
О: Для живых медиа обычно 1–3 недели, для тонких форумных страниц срок может уходить в бесконечность (отраслевая оценка). Практичная граница — 14 дней, после которых донор идёт в отправку.
В: Почему ссылка не индексируется, хотя страница отдаёт 200?
О: 200 — только первое условие. Дальше проверяют noindex в мета-теге и заголовке X-Robots-Tag, Disallow в robots.txt, canonical на другой адрес и то, что ссылка есть в сыром HTML, а не только после JavaScript.
В: Оператор site: для проверки индексации — можно ли ему доверять?
О: Положительному результату — да. Отрицательному — только после подтверждения вторым методом: сама документация Google называет выдачу оператора неполной.
В: Массовая проверка индексации ссылок — чем она отличается от отчёта «Ссылки» в Search Console?
О: Чекер снимает текущий статус донора в индексе и тайтл. Отчёт GSC показывает, что Google когда-либо обнаружил ссылку, и оставляет в списке даже страницы, которые могли исчезнуть.
В: Можно ли проверить индексацию донора через инструмент проверки URL в Search Console?
О: Нет. Инструмент принимает только адреса вашего подтверждённого ресурса; чужой URL он не проверит.
В: Что делать, если донор отправлен на индексацию, а на день 7 его всё равно нет в индексе?
О: Токены за него возвращаются, а сам донор после чистого прохода технических проверок — кандидат на замену. Решение о включении страницы в индекс принимает алгоритм, и повторные отправки редко его меняют.
Что изменится к 2028-му и что сделать сейчас
Факт: Google индексирует выборочно и открыто называет свои диагностические инструменты неполными; отчёт «Ссылки» ломается и отстаёт.
Категоризация: линкбилдер живёт в мире трёх источников — собственных технических проверок, парсинга выдачи и отчётов сервисов индексации, — и ни один из них не заменяет другие.
Оценка: к 2027–2028 году проверка доноров уйдёт в API-first сценарии, где список URL проверяется, отправляется и пересверяется по расписанию без ручных site:; это наше информированное мнение, а не измеренный тренд.
План на 10 минут: выгрузите последние 50 доноров в таблицу, снимите коды ответа одной командой curl, загрузите список в чекер индексации и посмотрите, сколько из них Google на самом деле видит.
Не проиндексированные после шагов 2–5 отправляйте на индексацию с предварительной проверкой и ждите отчёт на 7 день.
На что влияет SpeedyIndex и на что не влияет никто
Проверка индексации ссылок и отправка доноров в SpeedyIndex не требуют подтверждения сайта в Search Console или Яндекс Вебмастере: сервис принимает любые сторонние URL — беклинки, гостевые посты, крауд, PBN, Tier-2 и Tier-3.
Модель оплаты — Pay-per-Result: токены списываются только за успешно проиндексированные ссылки, 1 проиндексированный URL стоит 100 токенов.
Проверку сервис проводит на 7-й день для Google и на 15-й для Яндекса; токены за непроиндексированные URL возвращаются на баланс автоматически.
Отчёт по задаче разделяет URL на проиндексированные, непроиндексированные и с ошибками индексации — например, «Страница просканирована, но пока не проиндексирована», — и показывает тайтлы проиндексированных страниц. Опция предварительной проверки отсекает 404/410/451, страницы под robots.txt и noindex, медиафайлы и уже проиндексированные адреса до списания токенов.
Работать можно из веб-кабинета, Telegram-бота, расширения Chrome или через API для разработчиков. Бесплатные инструменты — извлечение URL из Sitemap XML, проверка редиректов, noindex, 404 и 5xx. Новым пользователям начисляется 200 бесплатных токенов.
Чего сервис не делает: не обещает 100 % индексации и не влияет на решение алгоритма. Если донор прошёл технические проверки и всё равно не попал в индекс на 7 день, это ответ поисковой системы, а не сбой процесса.
Проверьте свой список доноров через чекер индексации — и вы увидите, где именно заканчивается зона вашего контроля.