
Типичная история: после выкладки новой версии сайта трафик раздела проседает, а в Search Console растёт причина «Доступ к URL заблокирован в файле robots.txt». Виновато одно правило, которое на тестовом стенде никому не мешало. Проверка robots.txt онлайн до публикации занимает пять минут и снимает этот риск целиком. Ниже — по каким правилам Google решает, закрыт ли адрес, как найти конкретную строку, которая блокирует страницу, и какой порядок проверки встроить в каждую выкладку.
Почему Search Console больше не отвечает на вопрос «какое правило сработало»
Раньше в Search Console был отдельный инструмент проверки robots.txt: вставляешь путь, выбираешь робота, видишь подсвеченную строку. В конце 2023 года Google убрал его и запустил отчёт о файлах robots.txt. Отчёт полезен, но отвечает на другой вопрос: смог ли Google получить файл, когда он это сделал, какого размера файл и есть ли в нём ошибки разбора. Какое правило закрывает конкретный адрес, отчёт не показывает.
Для одного адреса на работающем сайте остаётся инструмент проверки URL: в разделе «Индексирование страниц» он покажет, разрешено ли сканирование. Но он работает только с уже опубликованными страницами вашего ресурса, по одной, и с той версией файла, которую Google успел закешировать. Черновик robots.txt им не проверить. Поэтому проверять правила нужно до выкладки, отдельным инструментом.
Как Google выбирает правило: пять пунктов, которые надо держать в голове
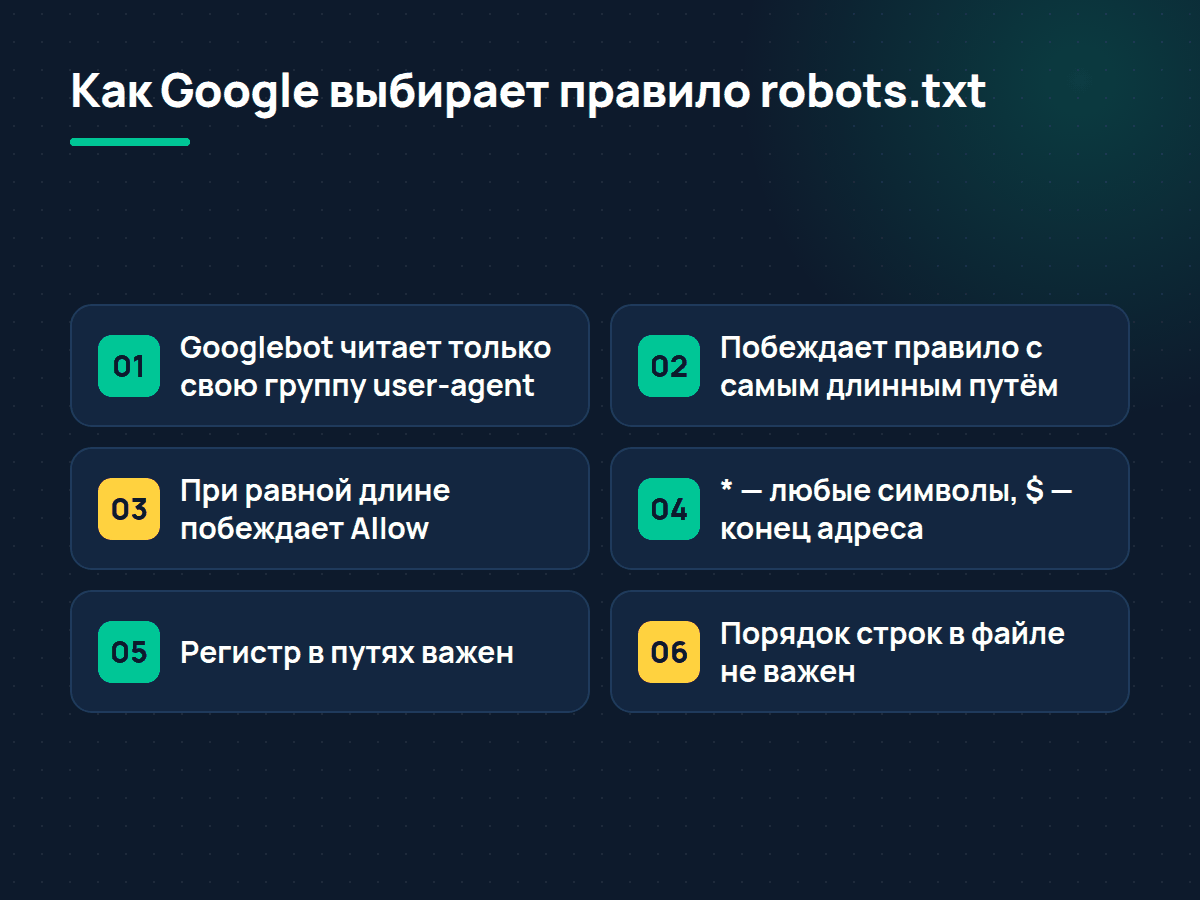
- Одна группа на робота. Googlebot выполняет только ту группу, где указан самый конкретный подходящий user-agent. Если такой группы нет — группу
User-agent: *. Группы с одним и тем же user-agent объединяются, а конкретная группа с общей*не складывается никогда. - Побеждает самое длинное правило. Из всех подошедших
AllowиDisallowрешает то, у которого длиннее путь. Порядок строк в файле значения не имеет. - При равной длине побеждает Allow. Google применяет наименее строгое из конфликтующих правил.
- Два спецсимвола.
*— любая последовательность символов,$— конец адреса.Disallow: /*.pdf$закроет/docs/a.pdf, но не/docs/a.pdf?v=2. - Регистр в путях важен.
Disallow: /Catalog/не закрывает/catalog/. А вот имена директив и user-agent регистр не учитывают.
Google поддерживает только четыре поля: user-agent, allow, disallow и sitemap. Crawl-delay, Host и Clean-param из шаблонов под Яндекс Googlebot просто игнорирует. Ещё одна граница — 500 КиБ: всё, что в файле дальше этого объёма, Google не читает.
Ищем правило, которое блокирует страницу: пример разбора
Возьмём файл интернет-магазина, где после выкладки Google начал сканировать тысячи страниц с фильтрами, хотя их «закрыли»:
User-agent: *
Disallow: /catalog/
Allow: /catalog/*/
Disallow: /*?filter=
Disallow: /*/print$

User-agent: Googlebot
Disallow: /search/
Disallow: /cart/
Разработчик рассуждал так: Disallow: /*?filter= закрывает фильтры, Disallow: /*/print$ — версии для печати, а Allow: /catalog/*/ длиннее, чем Disallow: /catalog/, поэтому разделы каталога открыты, а корень закрыт. Логика длины правил верная, но к Googlebot она не применяется вовсе. Ошибка в группах: когда в файл добавили блок User-agent: Googlebot для поиска и корзины, Googlebot перестал читать общую группу. Он выполняет только свой блок, поэтому для него открыто всё, кроме /search/ и /cart/: и фильтры, и печать, и корень каталога. Но и общая группа написана с ошибкой. Внутри каталога Allow: /catalog/*/ (11 символов) длиннее, чем Disallow: /*?filter= (10 символов) и Disallow: /*/print$ (9 символов), поэтому адрес /catalog/shoes/?filter=red по правилам Google открыт и для тех роботов, которые читают общую группу. Порядок строк здесь ничего не меняет.
Исправление в два шага. Первое — сделать запреты не короче разрешения: Disallow: /catalog/*?filter= и Disallow: /catalog/*/print$. Второе — повторить эти правила в группе Googlebot или убрать отдельный блок и перенести /search/ и /cart/ в User-agent: *.
Этот пример показывает главное: «на глаз» robots.txt читать нельзя. Нужно для каждого важного адреса выписать три вещи — какая группа применяется к роботу, какие правила этой группы подошли и какое из них длиннее. Именно так работает проверка robots.txt онлайн в бесплатном инструменте IndexFix Tools: вставляете текст файла или черновик, указываете робота (Googlebot, Googlebot-Image или любой другой) и список адресов, а инструмент для каждого адреса показывает «разрешено» или «закрыто» и строку, которая это решила. Сопоставление идёт в браузере, черновик никуда не отправляется.
Проверка robots.txt перед каждой выкладкой: порядок действий
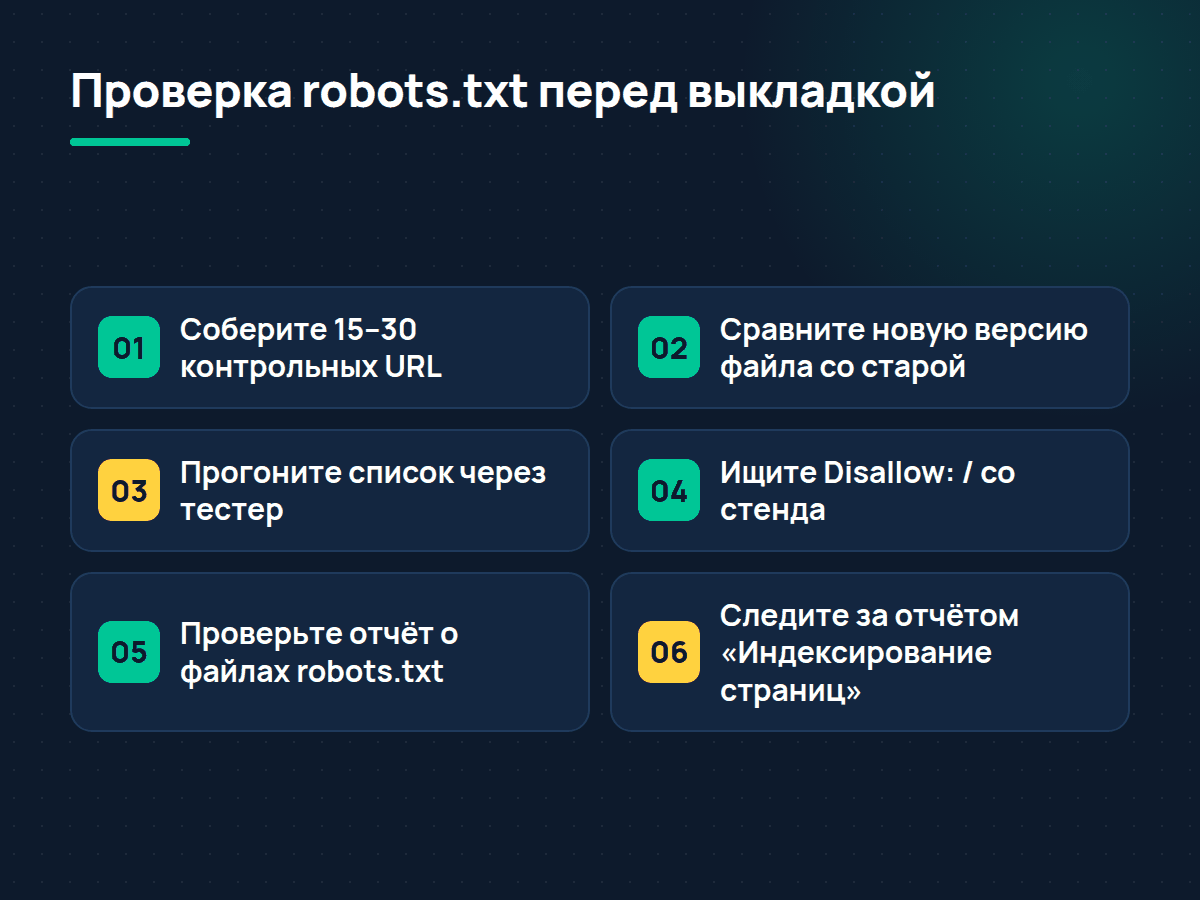
- Соберите контрольный список адресов. 15–30 URL: главная, по одному адресу из каждого шаблона (категория, карточка, статья, тег), страница с параметром, страница пагинации и несколько адресов, которые должны быть закрыты (корзина, поиск, личный кабинет). Список хранится рядом с проектом и меняется вместе со структурой сайта.
- Сравните новую версию файла со старой. Любая строка, которая появилась или исчезла, — повод проверить список. Особенно опасны изменения в начале групп: новая строка
User-agentможет отрезать правила от общей группы. - Прогоните список через тестер для Googlebot и для общей группы. Нужный результат: все рабочие адреса «разрешено», служебные — «закрыто». Если адрес открыт или закрыт неожиданно, смотрите, какая строка сработала, а не какую вы «имели в виду».
- Проверьте, не уехал ли на продакшен файл тестового стенда. Самая дорогая ошибка —
Disallow: /со стенда. Её ловит любой адрес из контрольного списка. - После выкладки откройте отчёт о файлах robots.txt. Новая версия должна получить статус «Получено» без ошибок. Если правка срочная, запросите повторное сканирование файла из меню отчёта. Google обычно кеширует robots.txt до 24 часов, и повторный запрос не гарантирует мгновенного обхода открытых адресов.
- Через несколько дней проверьте отчёт «Индексирование страниц». Рост причины «Доступ к URL заблокирован в файле robots.txt» по адресам, которые должны индексироваться, — сигнал, что правило шире задуманного.
Ответ сервера тоже часть проверки
Даже правильный файл не сработает, если сервер отдаёт его с ошибкой. Google читает код ответа так:
- 2xx — файл обрабатывается как есть;
- 3xx — Google проходит до пяти переадресаций, дальше считает, что файла нет;
- 4xx, кроме 429 — файла нет, ограничений на сканирование нет вообще;
- 5xx — первые 12 часов Google не сканирует сайт и пытается получить файл снова, затем до 30 дней пользуется последней удачной копией. Ошибки сети и тайм-ауты приравниваются к 5xx.
Отсюда два практических вывода. Закрывать сайт от сканирования ответом 401 или 403 на robots.txt бессмысленно: для Google это «файла нет». А нестабильный сервер, который время от времени отдаёт 503 на robots.txt, может на полдня остановить обход всего сайта.
Чего robots.txt не делает
Disallow запрещает сканирование, а не индексирование. Закрытую страницу Google не загружает, поэтому не видит на ней noindex, а сам адрес может остаться в выдаче, если на него ссылаются. Чтобы убрать страницу из поиска, откройте её для сканирования и поставьте noindex в метатеге или заголовке X-Robots-Tag. После того как вы открыли раздел, убедитесь, что адреса действительно вернулись в поиск: удобнее всего проверить индексацию сайта в Google списком, а не открывать каждый адрес в Search Console по одному.
FAQ
Где в Search Console проверить, какое правило robots.txt закрывает страницу?
Отдельного инструмента для этого больше нет. Отчёт о файлах robots.txt показывает, получен ли файл и есть ли в нём ошибки, а инструмент проверки URL — разрешено ли сканирование конкретного опубликованного адреса. Строку, которая сработала, показывает внешний тестер.
Если Allow и Disallow подходят к адресу одновременно, что победит?
Правило с более длинным путём. Если длина одинаковая — Allow.
Учитывает ли Google Crawl-delay и Host?
Нет. Google поддерживает только user-agent, allow, disallow и sitemap, остальные поля пропускает.
Как быстро Google увидит исправленный robots.txt?
Обычно в течение 24 часов — столько Google кеширует файл. Ускорить можно запросом повторного сканирования в отчёте о файлах robots.txt.
Можно ли закрыть страницу из поиска через robots.txt?
Нет. Robots.txt управляет сканированием. Для исключения из индекса нужен noindex, и страница при этом должна быть открыта для сканирования.
ИСТОЧНИКИ
- Как Google интерпретирует спецификацию robots.txt — Google Search Central: https://developers.google.com/search/docs/crawling-indexing/robots/robots_txt?hl=ru
- Отчёт о файлах robots.txt — Справка Search Console: https://support.google.com/webmasters/answer/6062598?hl=ru