
У популярной площадки узнаваемое имя, главная открывается, по домену в Google тысячи результатов. Кажется, что ссылка с такого сайта точно будет видна поисковику. На практике многие крупные платформы закрывают от индексации не весь сайт, а отдельные типы страниц: профили пользователей, загруженные файлы, посты. Закрытые от индексации страницы выглядят для человека совершенно нормально, но для Google их нет, и ссылка с них ничего не передаёт. Разберём, какие типы страниц оказались закрыты в нашем исследовании купленных ссылок и как определить тип страницы до того, как платить за размещение.
Откуда данные
Команда SpeedyIndex через год проверила 15 389 ссылок, которые сама покупала у исполнителей на Fiverr и Kwork: профили, Web 2.0, крауд, статьи и PBN трёх уровней (Tier 1, Tier 2, Tier 3). 21 августа 2026 года каждый URL обошёл краулер с User-Agent Googlebot Smartphone, а 29 октября 2026 года все ссылки проверили на наличие в индексе Google через Google Index Checker SpeedyIndex (запросы site:URL и URL).
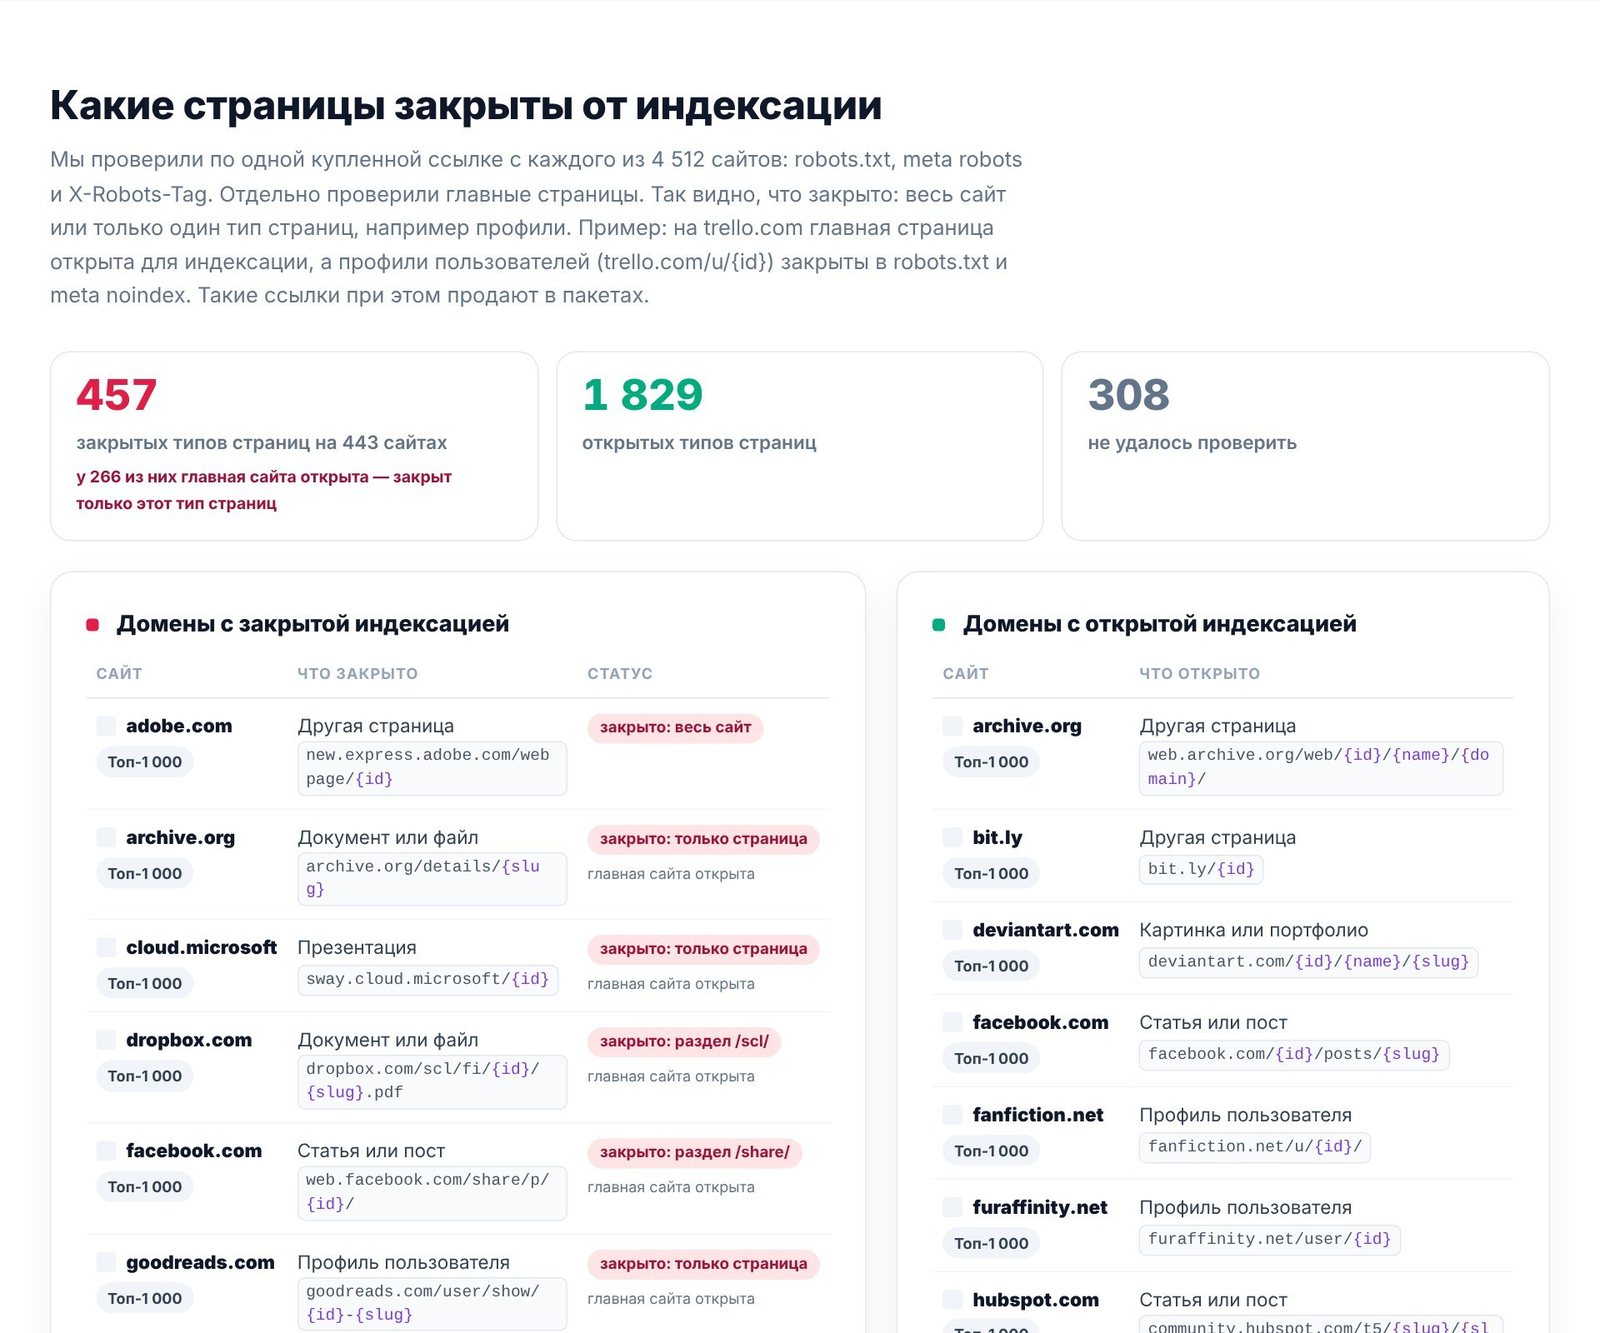
Отдельная часть исследования — таблица закрытых типов страниц. Для неё взяли по одной купленной ссылке с каждого из 4 512 сайтов и проверили три источника запрета: robots.txt, meta robots и заголовок X-Robots-Tag. Главные страницы проверили отдельно. Так видно, закрыт ли сайт целиком или только один тип страниц, например профили.
Закрытые от индексации страницы: 457 типов на 443 сайтах
Итог проверки выглядит так:
- 457 закрытых типов страниц на 443 сайтах;
- у 266 из этих сайтов главная открыта для индексации — закрыт только конкретный тип страниц;
- 1 829 типов страниц открыты;
- 308 типов проверить не удалось.
Ключевая цифра здесь — 266. На этих сайтах проверка главной показывает, что всё в порядке, хотя страница, на которой стоит ваша ссылка, закрыта. Классический пример — trello.com: главная открыта для индексации, а профили пользователей (trello.com/u/{id}) закрыты и в robots.txt, и через meta noindex. Такие ссылки при этом продают в пакетах.
Профили, файлы и посты: примеры из таблицы
Ниже — сайты из верхней части таблицы. Все они входят в топ-1 000 доменов, и со всех нам продавали ссылки.
| Сайт | Тип страницы | Шаблон URL | Что закрыто | Главная |
|---|---|---|---|---|
| goodreads.com | Профиль пользователя | goodreads.com/user/show/{id}-{slug} | только эта страница | открыта |
| linktr.ee | Профиль пользователя | linktr.ee/{name} | только эта страница | нет данных |
| archive.org | Документ или файл | archive.org/details/{slug} | только эта страница | открыта |
| dropbox.com | Документ или файл | dropbox.com/scl/fi/{id}/{slug}.pdf | раздел /scl/ | открыта |
| mediafire.com | Документ или файл | mediafire.com/file/{id}/{slug}/file | только эта страница | открыта |
| linkedin.com | Статья или пост | linkedin.com/posts/{slug} | только эта страница | открыта |
| facebook.com | Статья или пост | web.facebook.com/share/p/{id}/ | раздел /share/ | открыта |
| cloud.microsoft | Презентация | sway.cloud.microsoft/{id} | только эта страница | открыта |
| adobe.com | Другая страница | new.express.adobe.com/webpage/{id} | весь сайт | — |
Самое показательное в таблице — пары внутри одного домена. Посты по шаблону facebook.com/{id}/posts/{slug} в списке открытых, а посты по ссылкам вида web.facebook.com/share/p/{id}/ закрыты. На archive.org страницы web.archive.org/web/... открыты, а archive.org/details/{slug} с загруженными документами закрыты. Поэтому оценивать нужно не домен, а конкретный шаблон URL, по которому исполнитель размещает ссылку.
Почему «живая» ссылка всё равно не работает
Закрытые типы страниц — только часть проблемы. Из 15 389 купленных URL ответ HTTP 200 дали 4 750. Но код 200 ещё не значит, что страница может попасть в индекс: 15,7% из них закрыты noindex, а 32,4% имеют хотя бы один запрет индексации. Исполнитель показывает открывающуюся страницу, а Google видит на ней запрет.
По всей выборке с учётом всех сигналов закрыты от индекса 14,8% ссылок. Если смотреть на основную причину по каждому URL, meta robots noindex встретился у 547 ссылок (3,6%), Disallow в robots.txt — у 337 (2,2%), X-Robots-Tag: noindex — у 194 (1,3%).
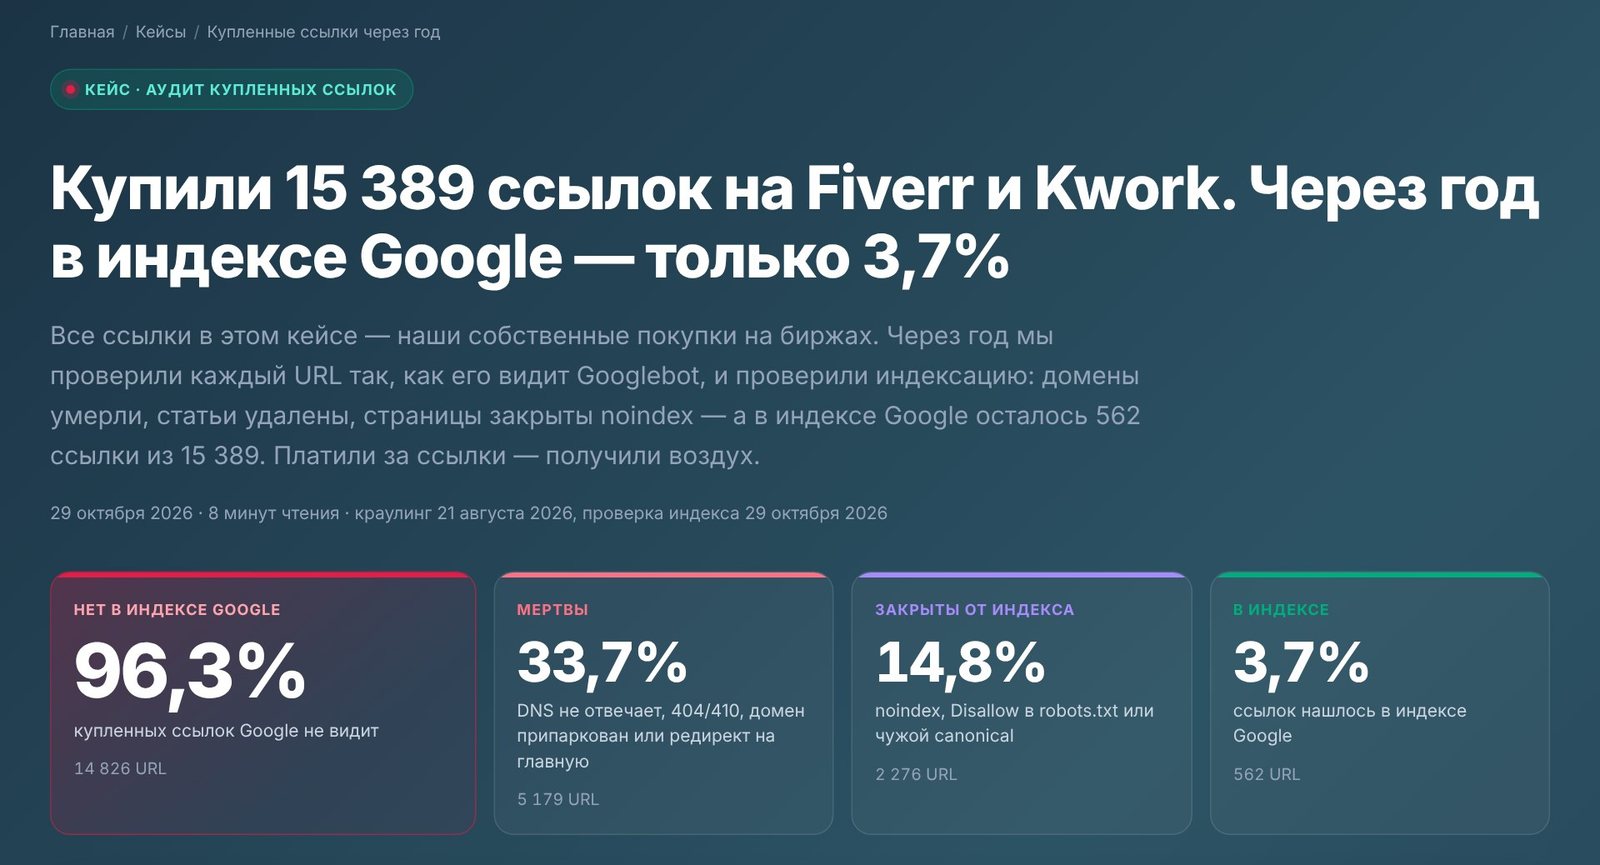
Открытая страница тоже не гарантирует результата. Даже среди технически чистых URL (HTTP 200, без noindex, Disallow и чужого canonical) в индексе Google оказалось только 8,6%. На популярных площадках из пакетов картина ещё жёстче: Diigo — 0 из 124 URL в индексе, Pinterest — 0 из 54, Medium — 0 из 46, Google Sites — 7 из 77. Запрет индексации — первый фильтр, который отсекает ссылку сразу и навсегда, но не единственный.
Как проверить тип страницы до покупки ссылки
Проверка занимает несколько минут и не требует платных инструментов. Делайте её на примере URL того типа, который вам продают, а не на главной площадки.
- Попросите пример размещения. Нужен реальный URL профиля, файла или поста, который исполнитель уже создавал на этой площадке. Главная ничего не скажет: у 266 сайтов из таблицы она открыта при закрытом типе страниц.
- Откройте robots.txt нужного хоста. Файл действует только для своего хоста, поэтому для
web.facebook.comилиsway.cloud.microsoftсмотрите robots.txt именно поддомена. Найдите группу для Googlebot илиUser-agent: *и проверьте, нет ли Disallow, который покрывает путь вроде/u/,/scl/или/share/. - Посмотрите meta robots в HTML. Ищите
<meta name="robots" content="noindex">или аналогичный тег для googlebot. Лучше получать страницу с User-Agent Googlebot Smartphone: ответ для робота и для браузера может отличаться. - Проверьте заголовки ответа. X-Robots-Tag: noindex не виден в коде страницы — только в HTTP-заголовках (вкладка Network в DevTools или
curl -I). - Проверьте код ответа, редирект и canonical. Нужен чистый 200 без перенаправления, а canonical не должен указывать на другой URL.
- Проверьте, есть ли в индексе страницы того же шаблона. Если ни одна страница вида
site.com/u/...не находится по запросу site:, это сигнал, что Google такие страницы не берёт.
Учтите одну тонкость. Disallow в robots.txt запрещает сканирование, а noindex — индексирование. Google в документации о блокировке индексирования прямо пишет: чтобы правило noindex сработало, robots.txt не должен блокировать роботу доступ к странице, иначе робот его просто не увидит. Для покупателя ссылки вывод один: любой из этих запретов означает, что страница не участвует в ранжировании как источник ссылки.
Что говорят правила Google
Честно о главном. Согласно правилам Google в отношении спама, покупка или продажа ссылок, которые учитываются при ранжировании, относится к ссылочному спаму. Платные ссылки допустимы для рекламы и спонсорства, если у них указан атрибут rel=»nofollow» или rel=»sponsored». Мы не призываем покупать ссылки. Исследование показывает ещё и практическую сторону: значительная часть купленных ссылок через год просто не работает, а размещение на закрытом типе страниц не работает с первого дня.
Пределы исследования
- Данные — только наши собственные заказы: 12 350 ссылок с Fiverr, 2 886 с Kwork и 153 с других бирж. Другие исполнители и площадки могут давать иную картину.
- Два среза: обход 21 августа 2026 года и проверка индекса 29 октября 2026 года. Площадки меняют правила, и закрытый сегодня тип страниц может открыться позже или наоборот.
- Таблица типов строилась по одной купленной ссылке с каждого из 4 512 сайтов. На сайте могут быть и другие типы страниц с иным статусом; 308 типов проверить не удалось.
- Проверку Cloudflare на JavaScript мы не обходили: 1 832 URL считаются непроверенными, а не мёртвыми. По редиректам не переходили.
- Каждый URL отнесён к одной основной причине, поэтому доля закрытых с учётом всех сигналов (14,8%) выше, чем доля группы «Закрыты от индекса» (8,1%).
Коротко
Популярный домен не гарантирует, что страница с вашей ссылкой открыта для Google. В исследовании 457 типов страниц на 443 сайтах закрыты от индексации, и у 266 из них главная при этом открыта. Среди них — профили, загруженные файлы и посты. Перед оплатой проверяйте конкретный шаблон URL: robots.txt хоста, meta robots, X-Robots-Tag, код ответа, canonical и наличие таких страниц в индексе. После размещения повторяйте проверку через 3, 6 и 12 месяцев: запреты и удаления появляются и спустя время.